
正文:
原文标题:DeepSeek’s 10 trillion USD grand strategy
原文编译:Peggy,BlockBeats
编者按:在过去的一年中,关于 DeepSeek 的讨论主要集中在其模型性能、开源策略以及价格竞争上。然而,如果仅仅通过「是否提供订阅服务」「是否具备多模态功能」「是否能够作为编程代理」来理解 DeepSeek,可能会低估其真正的目标。
本文提出了一个更具挑战性的观点:DeepSeek 的最终目标并非短期内通过应用层实现盈利,而是通过一系列底层架构的创新,重构 AI 训练与推理的成本结构,从而间接推动一个新的硬件生态的形成。从 MoE、MLA 到 DSA、CSA、mHC、Engram,再到 Dual Path 和 TileLang,DeepSeek 的技术路线始终围绕一个核心问题展开:在 HBM、先进制程、封装和 CUDA 生态受限的情况下,如何以更少的高端算力实现更强大的模型。
文章最值得关注的并不是「DeepSeek 是否能通过 API 或订阅赚取数亿美元」,而是其是否正在将模型能力、内存体系与国产硬件生态紧密结合。KV Cache 压缩技术减少了对 HBM 的依赖,而 NAND 和 SSD 则可用于长时间缓存,LPDDR 可以实现权重流式加载和 Engram 存储,TileLang 则试图削弱 CUDA 的技术壁垒。如果这些创新得以持续传播,受益者不仅仅是 DeepSeek 本身,还包括存储、ASIC、GPU、网络芯片以及整个 AI 基础设施链条。
当然,文中关于「10 万亿美元产业生态」和「1 万亿美元估值」的推测仍然充满不确定性,但它为理解 DeepSeek 提供了一个重要视角:开源并不一定意味着放弃商业化,低价策略也不单纯是市场补贴。对 DeepSeek 而言,真正的商业模式可能不在应用层,而在于助力更多硬件变得可用,从而实现低成本的 AI 供给。换句话说,它所出售的未必是模型本身,而是下一代 AI 基础设施的可能性。
你是否曾考虑过,DeepSeek 到底如何实现盈利,甚至可能赚取巨额利润?
与 GLM、MoonShot 和 MiniMax 等公司推出竞争力编程订阅方案不同,DeepSeek 似乎没有多模态、音频或视频模型。迄今为止,它甚至还没有构建自己的 harness,即用于模型调用、工具接入和任务执行的外层运行框架——虽然他们最近已经开始招聘相关人才,准备搭建这一体系。
与此同时,DeepSeek 似乎始终坚定地支持开源,甚至乐于分享其「秘诀」。这难道不是一种疯狂吗?难道是在无端烧钱?那些准备向其投资 100 亿美元的投资人,难道是在把钱扔进深渊吗?
接下来,我将基于 DeepSeek 迄今为止的举措,提出一些观察,并分析其似乎正在遵循的战略。DeepSeek 的 CEO 梁文锋的目标,可能远超当前的模型竞争。他所瞄准的或许是一个更大的目标:DeepSeek 有机会冲击 1 万亿美元的估值,同时推动一个规模达 10 万亿美元的新产业形成。
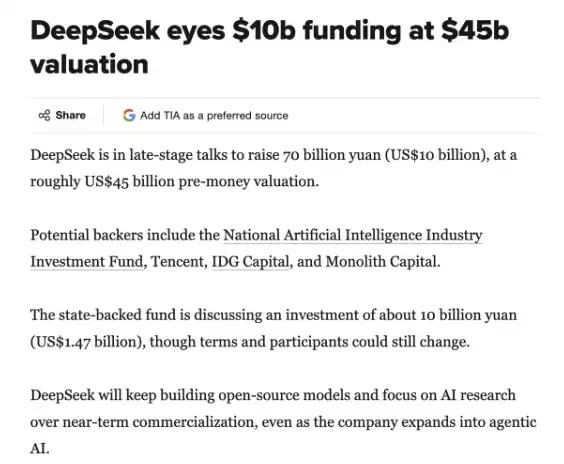
TechInAsia 关于 DeepSeek 最新一轮融资的报道
DeepSeek 在逆风中前行。它没有选择不断推出稍强的模型,并急于将其包装为可直接变现的应用,比如编程订阅方案。2025 年 1 月 27 日,我曾发过一条广为传播的推文,讲述我眼中 DeepSeek 的「英雄之旅」。如今,这个故事变得更加引人入胜。
当其他公司仍在尝试构建密集的模型时,DeepSeek 选择了更难训练的专家混合模型(Mixture of Experts,MoE)。
他们采用「第一性原理」的方法,发明了新的 GRPO 算法,取代当时主流但实现成本较高的 PPO 强化学习算法。
他们发现,基于可验证奖励的强化学习(Reinforcement Learning from Verified Rewards,RLVR)是提升模型推理能力的关键策略。
通过「多 Token 预测」(Multi Token Prediction),他们提出了一种简单的推测解码策略,使训练信号更加密集。
他们完善了「零气泡」(ZERO bubble)流水线,以提升有限 GPU 资源的利用效率。
他们发布了专家负载均衡器,使得 MoE 模型的部署变得更加便捷,尤其是通过「宽专家并行」(Wide Expert Parallel)策略,模型可以以更大的 batch 进行服务,从而显著降低推理成本。
他们发明了 MLA、DSA、CSA、HCA 等机制,以减少 KV Cache 的需求,并保持随着上下文长度增长而增加的计算需求尽可能恒定。
他们创造了 Engram,以内存换取计算效率。
他们还开发了 mHC,使得模型规模扩大时,依然能够实现稳定的训练。类似的例子还有很多。
在「英雄之旅」这一经典叙事结构中,英雄从来不会一开始就确定自己的旅程究竟通向何方。他在学习中逐渐发现自己的伟大使命,并在重重阻碍中完成它。他会遭遇许多质疑,但选择无视它们;他也会遭遇恶意的对手,尽管他有明显的缺陷,但最终会克服这些问题,完成使命。他面对看似无法跨越的挑战,却能找到结盟的方法,并学会如何明智地使用有限的资源。正是这一点,让观众愿意为英雄加油,也让 DeepSeek 赢得了追随者、全球的尊敬以及反对者。
正如我将在后文中详细说明的,DeepSeek 已经走过了这条道路很久,并逐渐发现了自己的终极目标:它的使命并非销售编程订阅方案,而是推动一个规模达 10 万亿美元的中国 AI 硬件生态,并实现 1 万亿美元的估值。在这个过程中,它也将为西方硬件生态中的众多新进入者创造机会。
请看 @SemiAnalysis_ 最近发布的推文:
DeepSeek 已经比任何人都更好地解决了这个问题!
我们先来进行一些有趣的 KV Cache 计算。别担心,即使你不喜欢数学也没关系。我们会使用最近发布的 KV Cache 计算器,来看看 DeepSeek V4 Pro 能带来多少 KV Cache 节省,并将其与最新的 GLM 和 Qwen 模型进行对比。
假设使用 100 万上下文长度进行计算,KV 精度为 8 bit,索引器精度为 16 bit。你也可以自己打开这个计算器试一试:https://kvcache.ai/tools/kv-cache-calculator/
·DeepSeek V4 只需 5.48GB HBM;
·Qwen3-235B-A22B 则需高达 89GB HBM。
·DeepSeek 是一个拥有 1.6 万亿参数的模型;
来源:Odaily星球日报
锦鲤(KoiPayment)原创作品,发布者:锦鲤KoiPayment,转载请注明出处:https://koipayment.com/2026/05/25/deepseek%e7%9a%84%e4%b8%87%e4%ba%bf%e7%be%8e%e5%85%83%e6%97%85%e7%a8%8b%ef%bc%9a%e9%80%9a%e8%bf%87%e5%bc%80%e6%ba%90%e6%8e%a8%e5%8a%a8%e5%ba%9e%e5%a4%a7%e7%9a%84%e7%a1%ac%e4%bb%b6%e7%94%9f%e6%80%81/
评论列表(8条)
DeepSeek的开源策略真的是个大突破!期待它如何改变硬件生态。
听说DeepSeek背后的团队很厉害,能否分享更多他们的成功故事?
万亿的目标太震撼了,看来未来金融科技将大有可为!
我觉得开源真的能带来更多创新,深度学习的未来会越来越好!
对于普通用户来说,DeepSeek的应用能否真正普及?期待!
文章提到的多模态功能好期待,希望能让我工作更高效!
DeepSeek在硬件生态上的布局很有前瞻性,想知道会有哪些新产品!
看完这篇文章让我对DeepSeek的未来充满期待,真是个值得关注的项目!